
Spring Boot в продакшене: гонки данных, Outbox и пул соединений в платёжной системе
Блоки кода в статье оформлены как тёмная IDE — их можно выделить и скопировать; на диаграммах никакого текста кода нет, это просто иллюстрации.
На локальной машине всё работает как часы: юнит- и интеграционные тесты проходят зелёным, и даже при небольшом числе одновременных пользователей никаких проблем не видно. Но стоит системе выйти в продакшен и начать принимать тысячи параллельных реальных платёжных запросов, как на бэкенде начинают всплывать неожиданные каскадные сбои.
При переходе от монолита к распределённым микросервисам самое сложное обычно не бизнес-логика, а сетевые задержки, согласованность данных и управление ресурсами. В этой статье я разберу три серьёзные проблемы, с которыми мы столкнулись в реальном продакшене, и расскажу, как мы решили их в системе на Spring Boot.
1. Гонки состояний и стратегии блокировки: проблема двойного списания
Что происходит, если один и тот же пользователь из-за нестабильного интернета дважды подряд жмёт кнопку «Оплатить», или когда два разных микросервиса обращаются к балансу одного и того же пользователя буквально в одну и ту же миллисекунду?
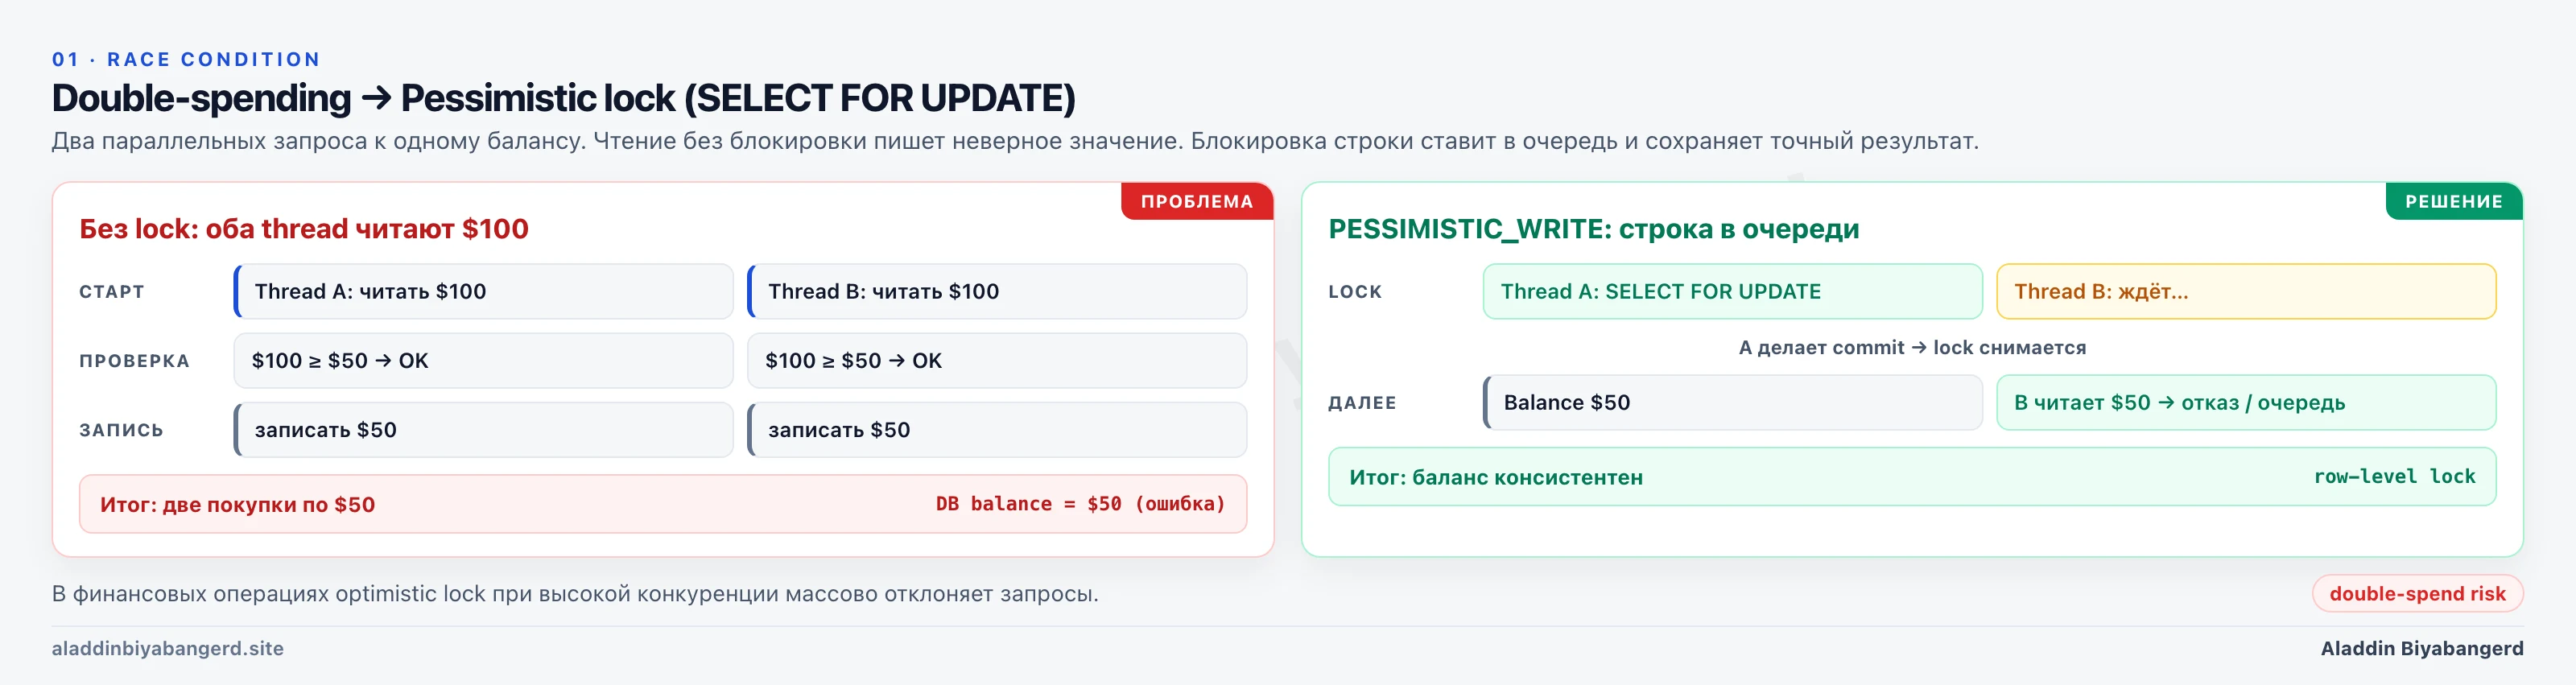
Представим, что на балансе пользователя $100, и он отправляет два отдельных запроса по $50. Оба потока одновременно читают из базы данных одно и то же значение — $100. Оба проверяют условие (баланс >= 50), оба проходят проверку, и оба потока списывают по $50 и записывают результат обратно в базу. Итог: пользователь начинал со $100, купил товаров на все $100, но в базе почему-то остаётся $50 вместо $0 — это и есть проблема двойного списания.
Чтобы решить эту проблему, мы сравнили две основные стратегии блокировки в JPA:
Оптимистичная блокировка (@Version): добавляет в таблицу столбец с версией. При чтении ничего не блокируется, версия проверяется только при записи. Это очень быстро при небольшой нагрузке. Но когда тысячи параллельных запросов одновременно бьют по одному и тому же балансу, начинается лавина исключений OptimisticLockException, и большинство пользовательских запросов просто отклоняется.
Пессимистичная блокировка (SELECT FOR UPDATE): именно этот подход мы в итоге выбрали для финансовых транзакций. Добавив аннотацию @Lock(LockModeType.PESSIMISTIC_WRITE) в JPA-репозитории, мы обеспечиваем блокировку строки на уровне базы данных:
public interface WalletRepository extends JpaRepository<Wallet, Long> {
@Lock(LockModeType.PESSIMISTIC_WRITE)
@Query("SELECT w FROM Wallet w WHERE w.userId = :userId")
Optional<Wallet> findByUserIdWithLock(@Param("userId") Long userId);
}
Как только первый поток завершает работу и коммитит транзакцию, все остальные потоки стоят в очереди на уровне базы данных до этого момента. В результате баланс обновляется точно и последовательно, без гонок.
Иллюстрация 1. Момент возникновения гонки состояний и механизм пессимистичной блокировки (SELECT FOR UPDATE).
2. Распределённые транзакции и паттерн Transactional Outbox
После успешного завершения платежа система должна уведомить другие сервисы (например, сервис уведомлений или выставления счетов), опубликовав событие PaymentCompletedEvent в Kafka. В самой первой версии мы допустили классическую ошибку:
@Transactional
public void processPayment(PaymentRequest request) {
Wallet wallet = walletRepository.findByUserIdWithLock(request.getUserId());
wallet.deduct(request.getAmount());
walletRepository.save(wallet); // 1. Обновляем баланс в БД
kafkaTemplate.send("payment-topic", new PaymentEvent(wallet.getId())); // 2. Отправляем сообщение в Kafka
}
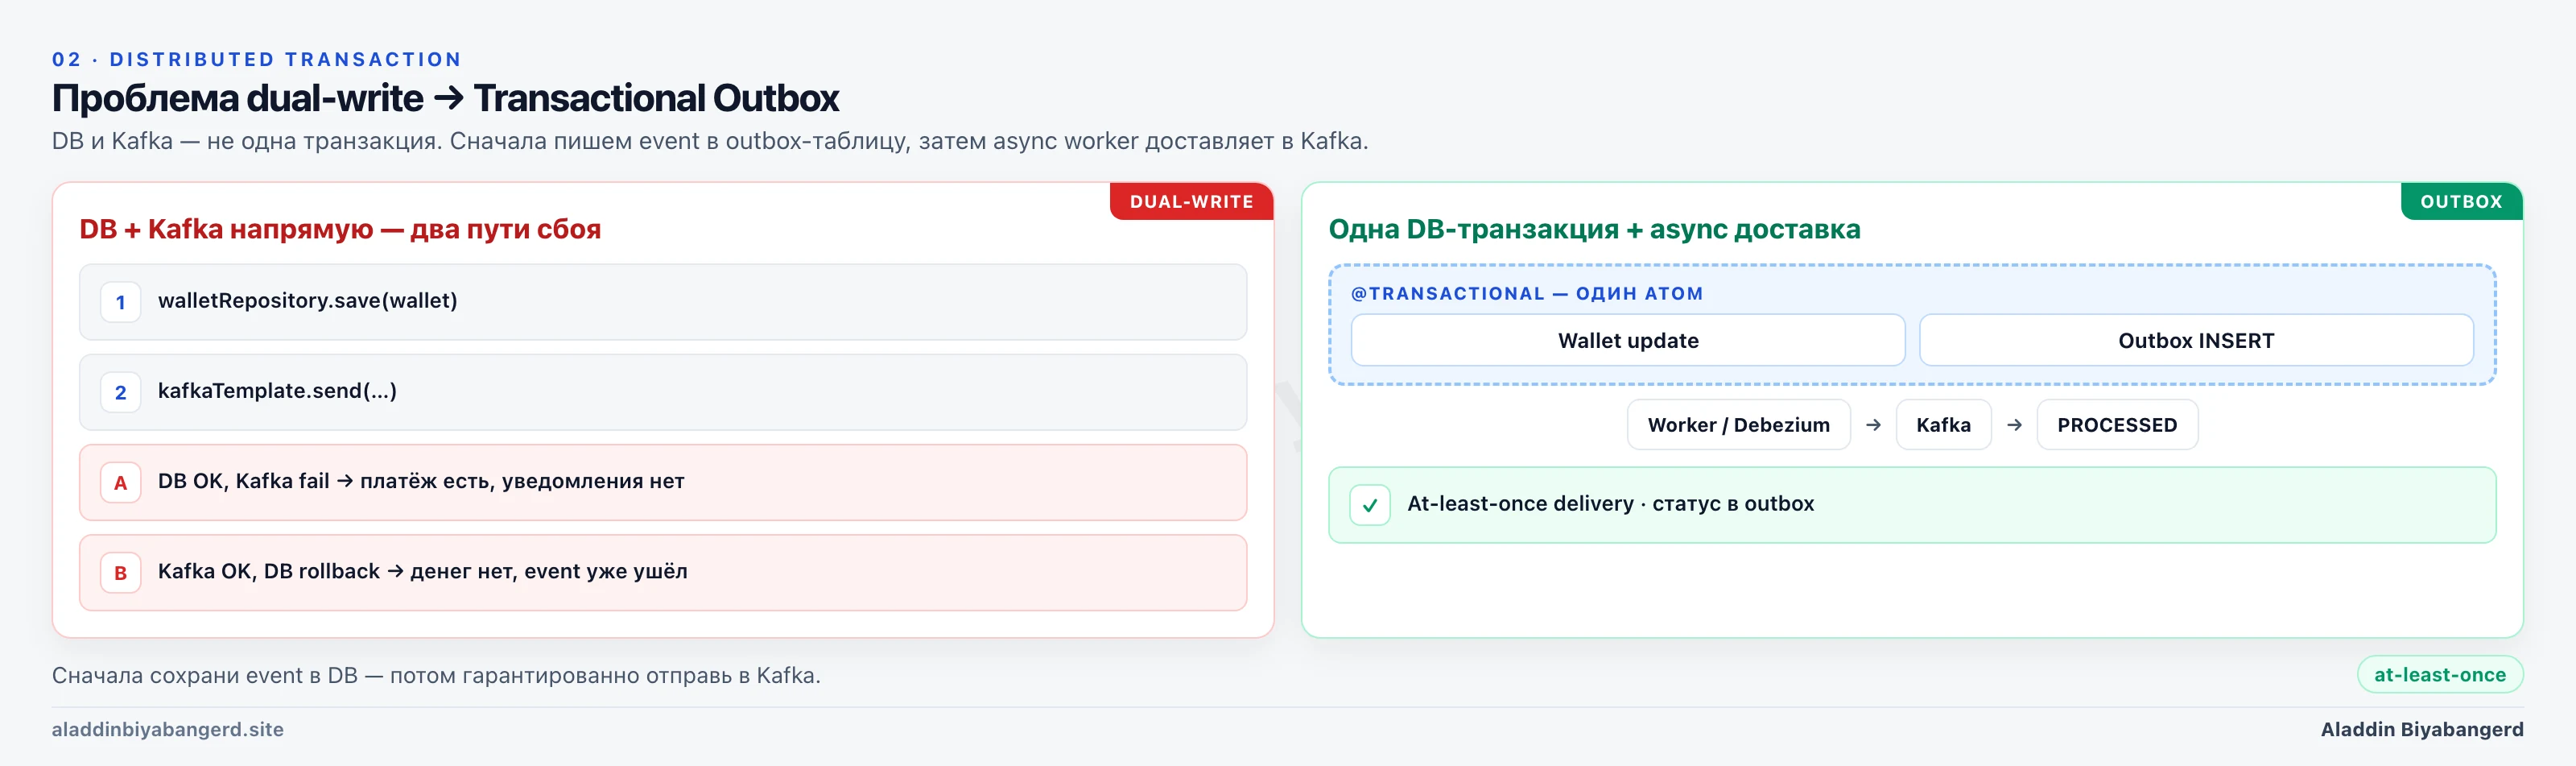
Такой подход несёт в себе серьёзный риск — классическую проблему двойной записи (Dual-Write Problem):
Если транзакция в базе данных закоммитилась, а сообщение из-за сетевой ошибки не дошло до Kafka, платёж прошёл, но уведомление никогда не отправится.
Если сообщение в Kafka успешно ушло, а транзакция в базе данных сразу после этого упала и откатилась, деньги фактически не списаны, но другие сервисы уже уверены, что платёж прошёл.
Решение мы нашли, применив паттерн Transactional Outbox:
Вместо прямой публикации в Kafka мы записываем событие в отдельную outbox-таблицу в рамках той же транзакции с базой данных.
Отдельный асинхронный фоновый воркер (или Debezium CDC) читает новые записи из outbox-таблицы и надёжно доставляет их в Kafka (с гарантией доставки at-least-once).
После успешной доставки сообщения в Kafka соответствующая запись в outbox помечается как PROCESSED.
Иллюстрация 2. Паттерн Transactional Outbox — запись в outbox в рамках транзакции с БД и асинхронная пересылка в Kafka.
3. Пул соединений HikariCP и долгие транзакции
Одна из самых критичных проблем, с которой мы столкнулись при высокой нагрузке, — ошибка Connection is not available, request timed out after 30000ms.
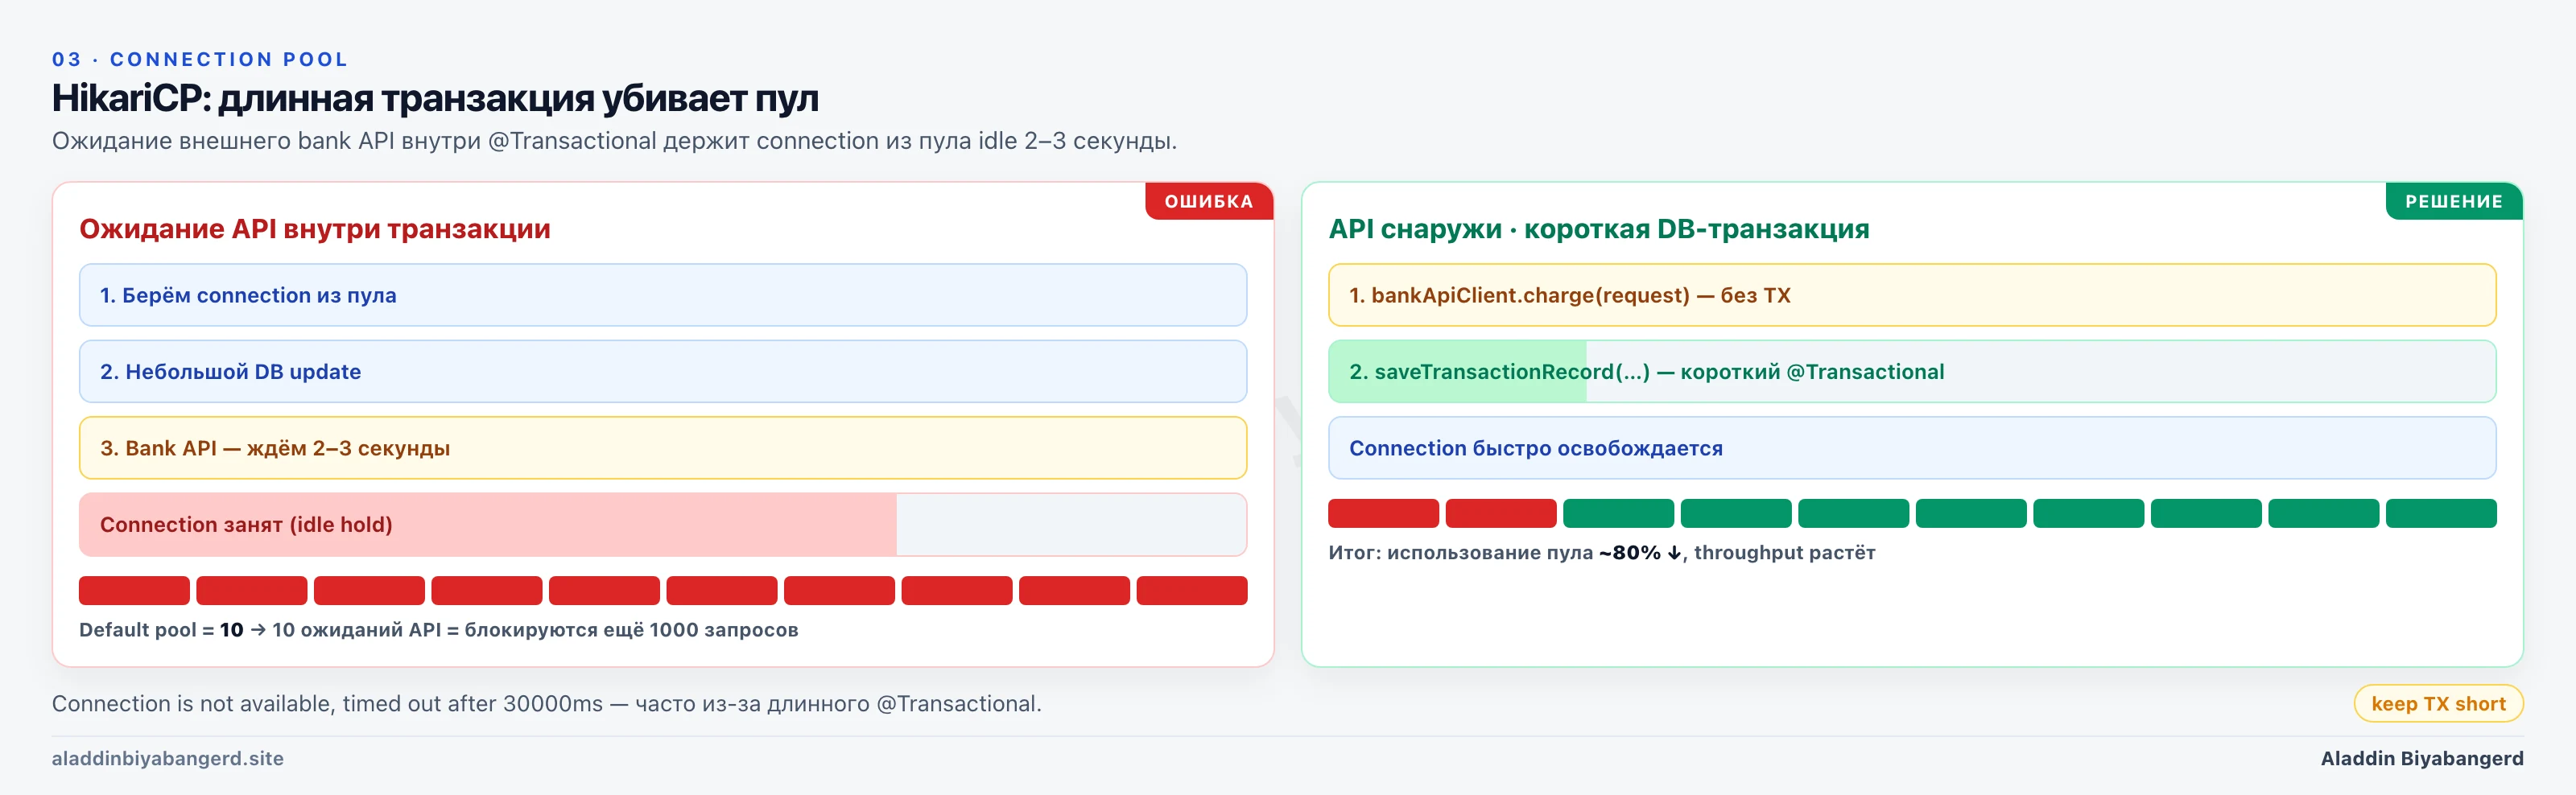
Разобравшись в первопричине, мы выяснили, что разработчики вызывали внешний REST API банка прямо внутри метода, помеченного аннотацией @Transactional.
Пока идёт сетевой запрос к банку, соединение с базой данных остаётся занятым и удерживается этим потоком — оно не возвращается в пул. При высокой нагрузке все соединения в пуле HikariCP быстро оказываются заняты такими «зависшими» транзакциями, и новые запросы просто не могут получить свободное соединение, упираясь в таймаут.
Решение — разделить ответственность: вызов внешнего API нужно выносить за пределы транзакционного блока, а транзакцию с базой данных делать максимально короткой и охватывать только реальные операции с данными. Так соединения возвращаются в пул сразу же после завершения работы с базой, а не простаивают в ожидании ответа от внешней системы.
1 человек прочитал эту статью


Комментарии
Войдите, чтобы оставить комментарий. Войти